光计算利用光的传播完成运算,具有高并行计算的潜力。但在一颗光计算芯片发挥作用之前,研究人员要先回答一个复杂的问题:怎样设计微纳结构,才能让光按照预期完成计算?
9月11日,在2026 IEEE全球光电子大会(OGC)“光电子EDA软件”专题研讨中,光子芯力创始人、湖南大学半导体学院副教授杨其晟分享了报告《LightningFNO:面向光子矩阵—向量乘法计算单元的超快速建模与逆向设计》,介绍团队如何用AI加速光芯片设计。
这场报告讨论的不只是一个AI模型的速度,也包括生成的结构能否被验证、制造后的器件表现如何,以及器件模型怎样用于更大的计算任务。
01先理解问题:一张计算任务,怎样变成一颗光芯片?
神经网络常常需要把一组输入按不同权重组合,再得到输出。数学上,这类操作可以写成矩阵—向量乘法。超表面光计算单元让输入光穿过经过设计的微纳结构,利用光在其中的传播和相互作用,形成目标输出。
论文研究的一个对象是4路输入、4路输出的计算单元。它的计算区域约为10微米×10微米,设计模型用100×100的二值网格表示材料结构。每个局部结构的变化都可能影响整体光场,因此研究人员很难仅凭直觉画出满足目标矩阵的布局。
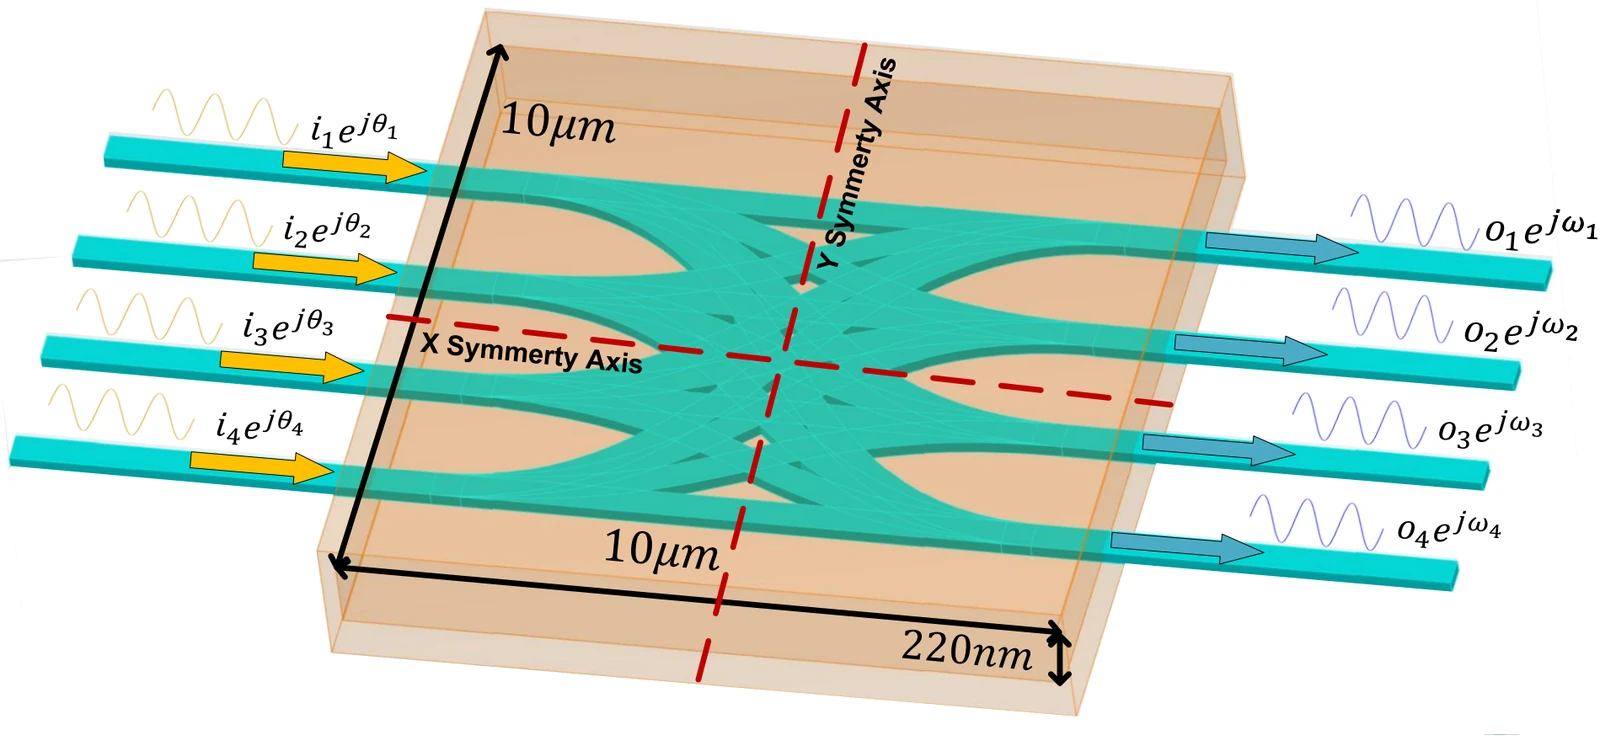
研究中的4×4超表面光计算单元。输入光经过微纳结构后,从四路输出端读取响应。图源:杨其晟博士OGC报告。
传统设计通常从一个候选结构出发,用电磁仿真计算它的光学响应,再反复修改。三维时域有限差分仿真(FDTD)能够细致描述光场,却也需要较高的计算开销。目标矩阵一变,设计流程可能就要重新搜索。
LightningFNO要解决的,是让模型在完成前期学习后,更快地回答两个问题:目标矩阵对应什么结构?这份结构又会产生什么光学响应?
02AI做两件事:生成设计,也检验设计
LightningFNO采用两个相互配合的模型。逆向FNO接收目标矩阵,生成候选超表面结构;正向CFNO读取结构,预测光通过之后的响应。把预测响应与目标对照,就能快速筛选候选方案。
LightningFNO 的设计流程
- 01目标矩阵
- 02逆向模型生成候选结构
- 03正向模型预测光学响应
- 04与目标比较,决定接受或继续优化
这里的“傅里叶”是一种帮助AI模型处理空间信息的数学方法。超表面上的各处结构会共同影响光的传播,模型需要同时学习局部几何和较远区域之间的联系。正向CFNO因此把卷积特征提取与傅里叶神经算子结合起来。
团队还设置了筛选机制:当预测响应与目标足够接近时,候选方案进入快速设计路径;差距较大的方案则作为伴随优化的初始结构,继续精细调整。AI负责加快探索,困难案例仍保留进一步优化与物理验证的路径。
训练模型同样需要前期投入。研究人员先生成1000个目标矩阵,通过FDTD与伴随优化得到对应的结构样本,再利用对称性扩展为4000份训练样本。理解这一步,才能准确看待后面的速度数据。
03设计、实测、应用评估:三组结果各说明什么?
报告把研究证据分成三个层级。它们共同支持这一设计流程,却不能被理解成同一个“整机性能”指标。
设计:训练完成后,单次推理约4毫秒
在论文的4×4单元测试中,LightningFNO训练完成后的单次设计推理约需0.004秒;对照的伴随优化方法约需4982.20秒。两者在报告采用的设计评价指标上均为0.0175,对应约124.6万倍的耗时差异。
这个比较没有计入训练数据生成、模型训练及可能需要的后续精细优化。它反映的是特定测试中的重复设计效率,并非光芯片运行速度或产品研发全周期的提速。
实测:3×3原型器件呈现预期光学响应
为了走出仿真,团队制造了三个3×3光子矩阵—向量乘法原型单元。下图由器件整体逐级放大,可以看到实际制成的微纳计算区域。这里的3×3原型与前述4×4设计测试规模不同。
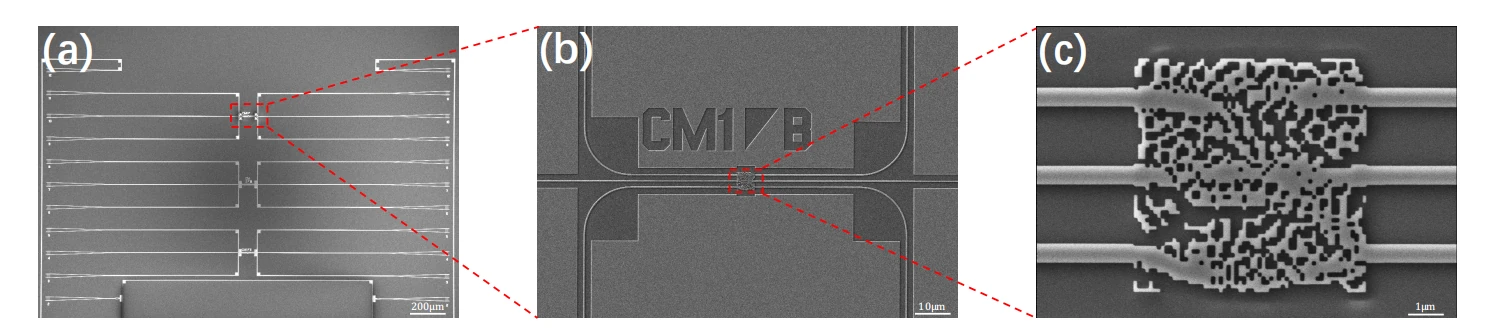
已制造的3×3原型器件。三幅扫描电镜图依次展示器件、计算区域与微纳结构。图源:杨其晟博士OGC报告。
在1000组随机输入向量的测试中,团队比较了目标、仿真与实测输出,报告给出的整体实测均方根误差(RMSE)为0.0430。这项结果说明原型器件的光学响应可以接受实验测量与目标对照;它尚不是一张完整计算板卡的性能测试。
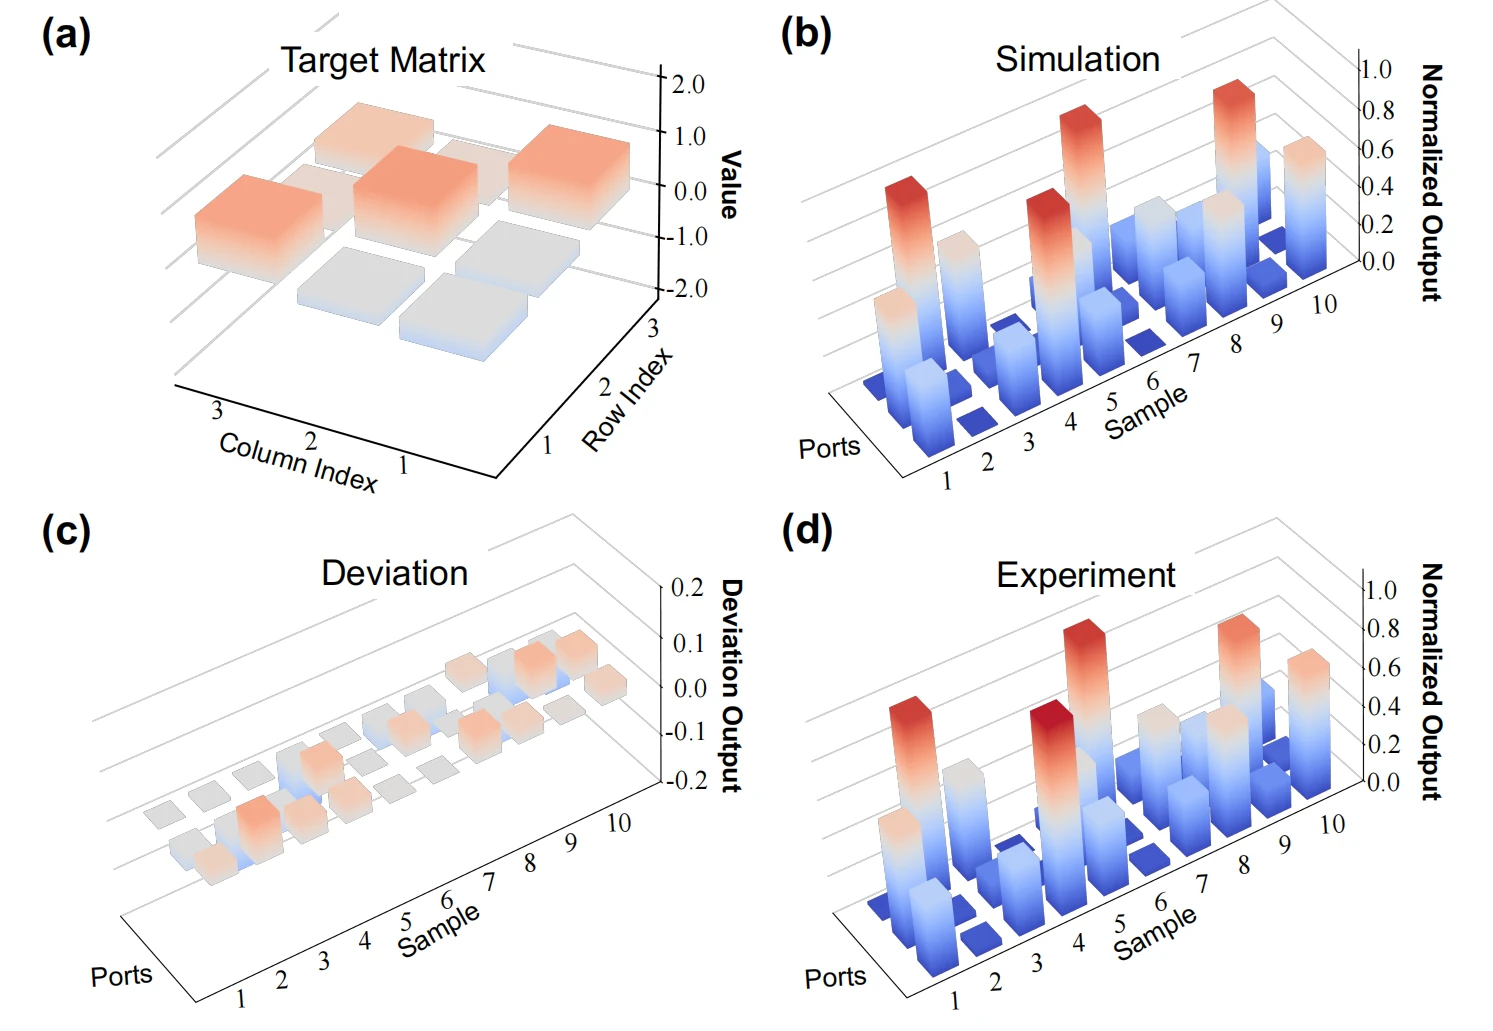
目标矩阵、仿真输出、偏差与实测输出的对照。整体实测RMSE为0.0430。图源:杨其晟博士OGC报告。
应用评估:把器件误差放进识别任务
团队进一步将神经网络中的计算映射到4×4光学单元,并用正向CFNO预测其响应。评估还纳入了实测器件的制造误差分布,以观察这些误差对手写数字识别任务的影响。
在MNIST任务中,电子计算基线准确率为98.29%,光学映射后的系统级仿真结果为97.69%,相差0.60个百分点。这里展示的是结合器件实测误差的系统级建模结果,并非整套光学神经网络的硬件实测。
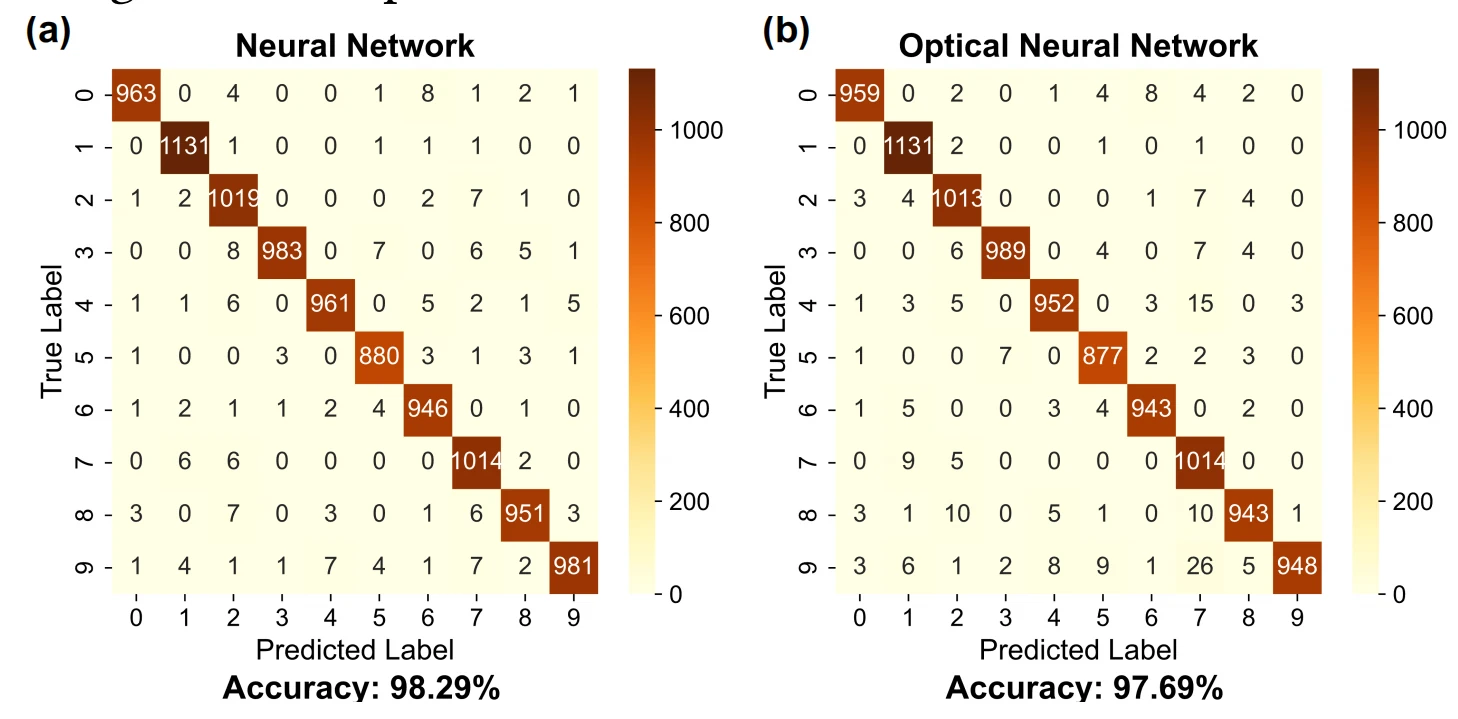
MNIST手写数字识别评估:电子计算基线98.29%,光学映射仿真97.69%。图源:杨其晟博士OGC报告。
04让研究成果进入可重复的设计流程
LightningFNO的意义,在于把“生成结构”和“预测响应”连接起来。前者帮助研究人员寻找满足目标的器件方案,后者可用于快速筛选,并支持更大计算任务的建模。
要把这种方法用于实际系统,还需要把器件模型接入光电协同仿真,考虑电子部分如何控制和调度光计算,并将制造、测量得到的数据反馈到下一轮设计。光子芯力正在推进的EPDA光电设计自动化平台,正围绕这些环节建立可复用的接口与验证流程。
报告也明确了现阶段工作的边界:器件与模型研究已有实验依据,编译器整合、面向图像和视频任务的评估,以及更深入的工艺平台衔接,仍需持续推进。
让AI加快设计,也让预测结果经得起仿真和实测检验。光计算芯片走向实际应用,需要这两方面一起向前。
图表与研究数据依据杨其晟 OGC 2026 报告 PPT