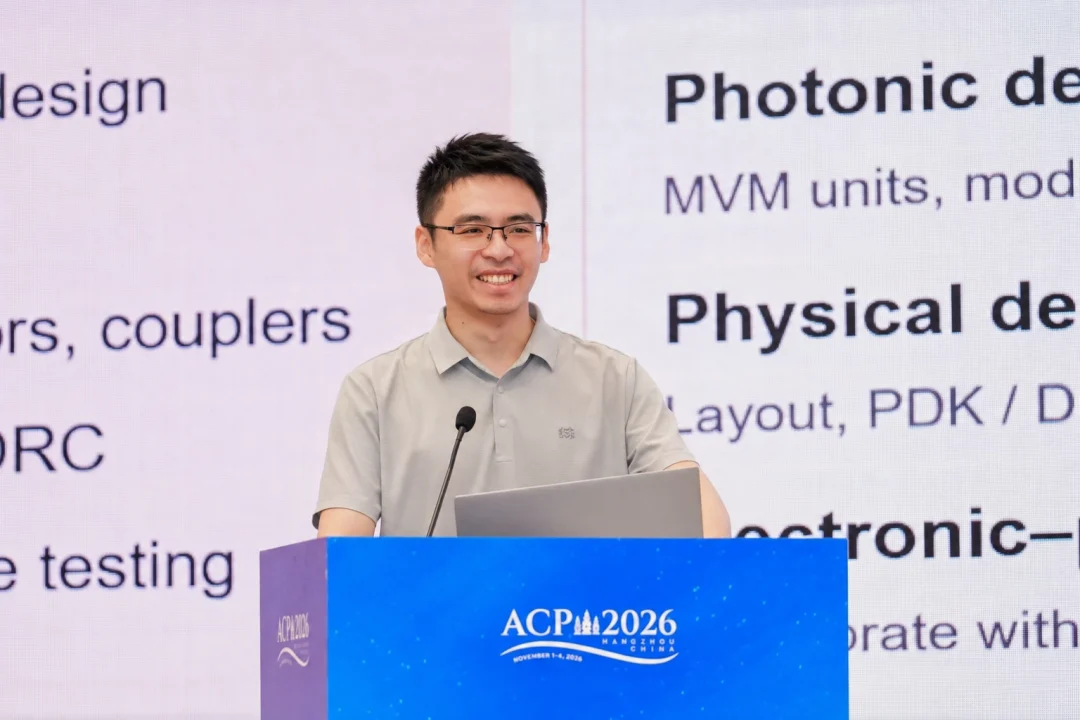
11月1日,在杭州举办的ACP2026"Programmable Photonics and Applications"专题研讨会上,光子芯力创始人杨其晟博士作题为"From Fast Photonic Design to Better Token Economics"的报告分享,围绕光子矩阵乘法器件的快速设计、光电协同设计平台与异构计算系统,分享光计算走向实际AI服务的技术思路。
01光计算走向应用,先跨过设计与系统两道门槛
矩阵—向量乘法(MVM)是神经网络等计算任务中的基础运算,而光在器件中的传播及光场耦合,为这类运算提供了快速、紧凑的物理实现方式。
但要让光学结构完成指定的矩阵运算,首先要回答:给定一个目标矩阵,应该设计怎样的器件结构?这个结构的光学响应,又是否符合预期?
传统设计需要在"目标矩阵—器件拓扑—光学响应"之间反复迭代。对于高像素、全局耦合的结构,每一次全波电磁仿真都可能带来较高计算开销;遗传算法、直接二进制搜索与伴随优化等方法,也需要不断评估候选结构。光学运算本身很快,设计与验证的过程却可能十分漫长。
另一道门槛来自系统。光计算核心还需要与存储、数据转换、驱动控制、主机接口及软件栈配合,器件层面的优势能否保留到应用层面,取决于这些环节怎样共同工作。
因此,器件与系统设计都必须围绕具体工作负载展开:既要让器件更快被设计出来,也要让它进入系统后真正发挥作用。
02LightningFNO:让结构生成与响应验证同时加速
针对器件设计中的反复求解,LightningFNO采用双算子框架,同时学习"从目标到结构"和"从结构到响应"两个方向:
第一步,逆向傅里叶神经算子(FNO)接收目标矩阵,生成二值化器件拓扑;第二步,前向模型CFNO结合卷积网络的局部几何特征提取与傅里叶神经算子的全局频谱表达,快速预测该结构的光学响应,并与目标比较。置信度高的候选进入快速设计路径;困难目标则可以生成结果初始化伴随优化,继续进行高精度设计。
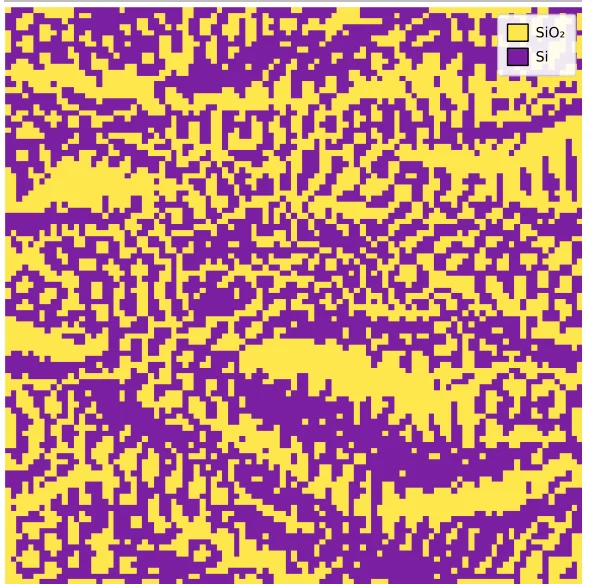
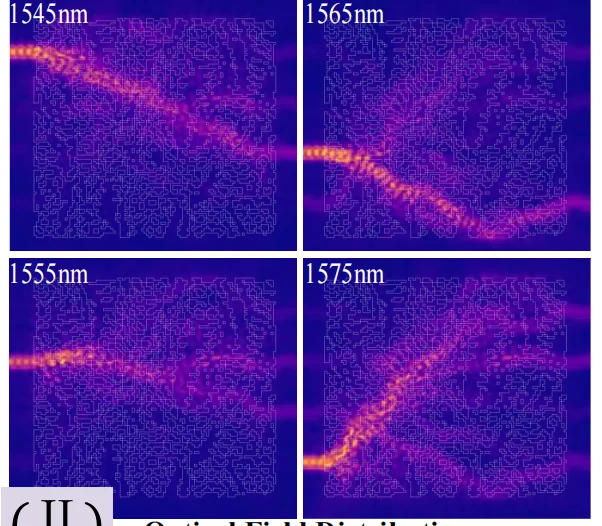
LightningFNO器件拓扑与不同波长下的光场分布(摘自报告)
- 01
设计速度:4毫秒完成一次基准设计推理。在4×4矩阵乘法单元基准中,LightningFNO训练完成后的单次设计推理约0.004秒,作为对照的伴随优化约4982.20秒;两者报告的设计评价指标FOM均为0.0175,对应约124.6万倍的速度提升。需要说明的是,这一加速比特指该基准中、模型训练完成后的单次设计推理,不包含离线数据生成、模型训练与精修成本,也不等同于光芯片运行速度——它展示的是学习方法快速筛选设计空间的价值。
- 02
器件验证:从预测走向加工与实测。研究进一步加工了3×3矩阵乘法原型器件,在1000个随机输入向量下,整体实测光学响应均方根误差(RMSE)为0.0430。
- 03
应用评估:将器件误差带入神经网络。在MNIST手写数字分类任务中,结合前向代理模型与器件实测误差分布进行硬件感知评估,光学映射卷积神经网络获得97.69%的分类准确率。这一结果也反映了模型映射到带有实际误差的光学计算单元后的应用表现。
设计推理、器件实测与应用评估,分别回答"设计是否更快""器件是否准确""误差能否被应用接受"三个问题,共同构成了从方法到应用的验证链条。
03EPDA:把器件、编译与物理实现连成协同设计闭环
快速器件模型为更大范围的系统探索创造了条件。光子芯力进一步通过EPDA(电子—光子设计自动化),将器件能力与应用需求连接起来:从神经网络、算法与算子需求出发,联合评估光、电器件及其实现方式,再把系统瓶颈反馈到器件参数、光电划分、编译映射与架构设计中。一个算子适合放在光域还是电域、模型如何切分映射、数据搬运是否抵消计算收益——这些问题在同一个设计过程中共同评估,让硬件选择与编译策略持续迭代。
在平台架构上,EPDA通过统一接口连接器件模型、链路与系统构建、联合仿真、优化及逆向设计等能力,向上衔接神经网络编译、测量校准与用户接口;针对不同环节所需的精度,可通过适配器调用全波电磁求解、电路仿真、版图检查与晶圆厂PDK等工具。LightningFNO既是可复用的器件逆向设计组件,也是系统评估中的快速响应模型。
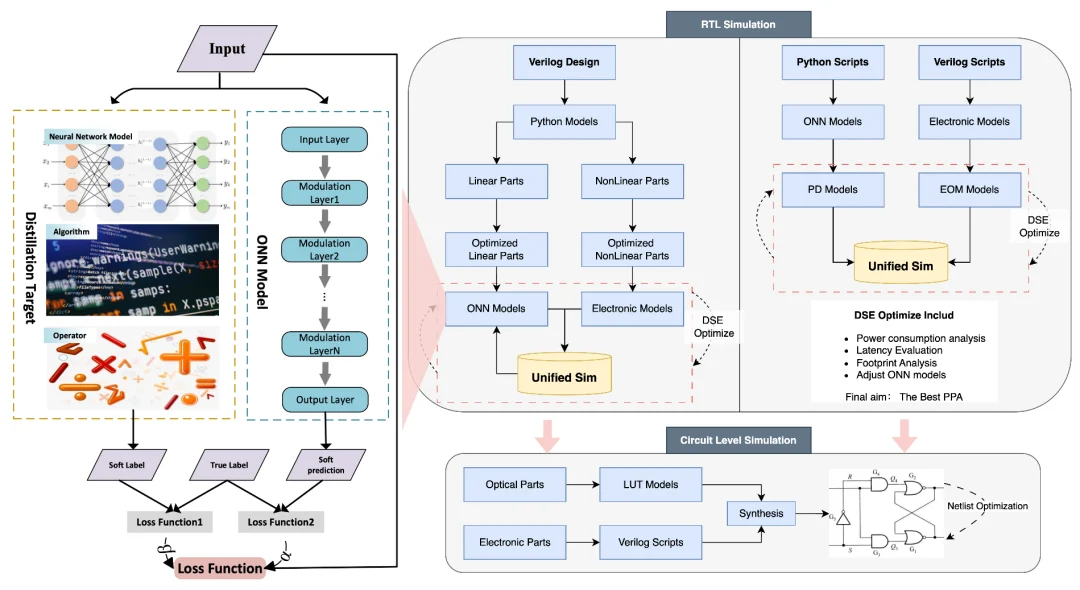
EPDA完整协同设计流程:输入、联合仿真与电路级反馈(摘自报告)
当协同范围延伸到系统,模型切分、映射与调度也成为设计变量,应用指标和瓶颈分析能反过来推动存储、互连与器件方案的调整,寻找给定任务和约束下更合适的整体实现方案。
04从光计算核心到可用板卡,需要完整的光电异构系统
一颗光子矩阵乘法器件进入真实应用,需要周围完整的电子系统支持:输入端的数模转换、调制器与偏置驱动,输出端的光电探测、跨阻放大与模数转换,以及激光器驱动、时钟、电源管理、温度控制、主机接口与外部存储。每一次电光或光电转换、每一次数据搬运,都会引入延迟、能耗与成本。如果只关注光计算核心的峰值算力,就难以判断整块板卡或集群的实际表现。随着系统从单卡扩展到多卡、多机架,计算、存储、互连及软件必须放在一起设计,器件的物理优势才能转化为系统收益。
而PhotonXcale正是这一系统思路的产品方向:
- 01
存储侧,通过CXL内存池扩展容量,让权重和KV cache等资源可以池化,减少重复副本和不必要的重算。
- 02
互连侧,利用光路交换(OCS)连接板卡与机架, 为系统弹性扩展提供支撑。
- 03
计算侧,由光计算单元(OPU)与近存NPU协同承担适合的算子,根据工作负载将矩阵、归约或注意力相关运算映射到合适位置,让计算尽量靠近数据。
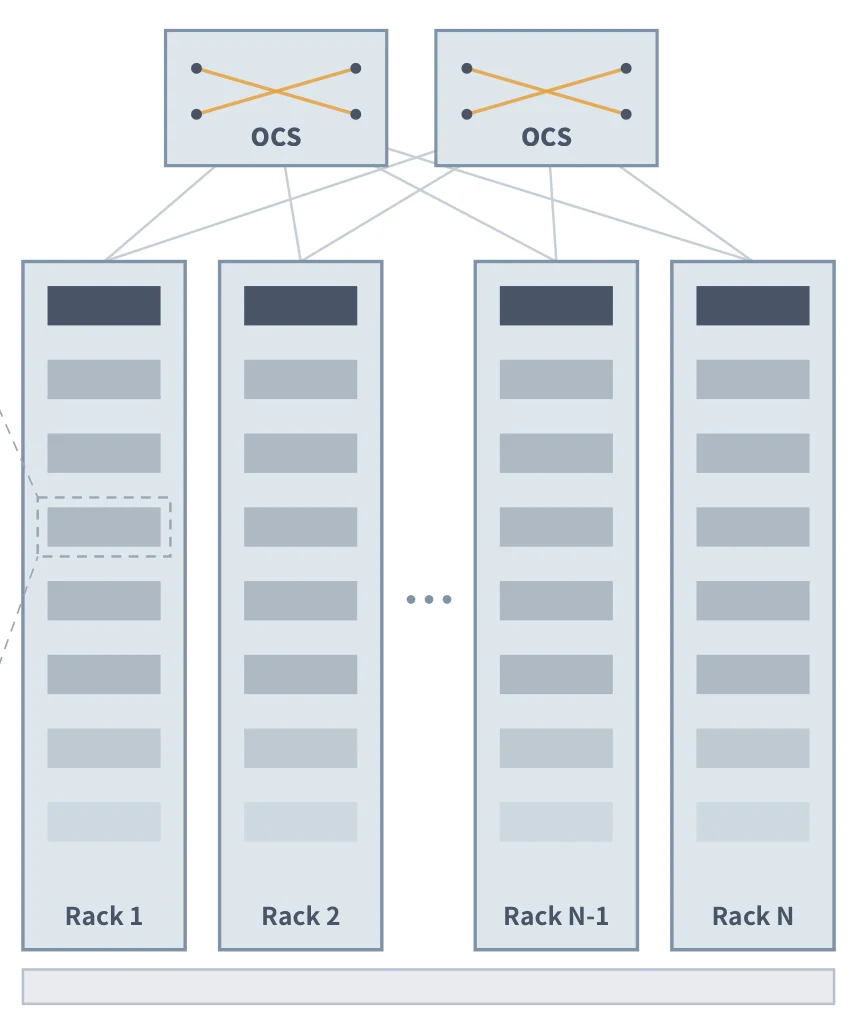
多机架光互连架构示意(摘自报告,规划概念)
这里的重点不是三个模块各自堆到最大,而是根据工作负载共同优化数据路径,让有效吞吐真正提升。
05以每一个有效Token,检验光计算的应用价值
当器件设计、软件工具与系统架构逐步连接,评价标准也需要回到AI服务本身。Token可以简单理解为模型处理与生成文本的基本单位。但一项AI服务不能只看每秒生成多少Token——精度、首Token延迟(TTFT)与Token间延迟等服务要求,决定了交付的Token是否真正"有效"。由此,系统评价需要同时关注三组指标:
- 01
有效吞吐:既定约束下,每秒能够交付多少有效Token;
- 02
服务体验:是否满足首Token延迟(TTFT)和Token间延迟等服务要求;
- 03
成本与能耗:每百万有效Token的成本,以及每个Token消耗的能量。
成本侧要覆盖计算、存储与互连,计入设备折旧、电力与运维;产出侧是在约束下真正交付的Token。光计算降低单次矩阵运算的成本,存储池化减少复制与重算,光互连缓解扩展瓶颈——只有这些收益同时反映到系统级指标上,才算真正优化了Token经济学。