2026 年 9 月 20 日,上海,在 2026 全球 AI 芯片峰会上,光子芯力科技有限公司 CTO 袁光 受邀在「AI芯片架构创新技术研讨会」上发表了题为《光电融合计算:人工智能计算系统的新机会》的演讲。其主要围绕大模型时代 AI 计算系统面临的算力、能效与可扩展性三重瓶颈,介绍了以超表面光计算为核心的光电融合计算范式。
01从电摩尔走向光摩尔
袁光指出,随着大模型参数规模和推理并发持续增长,目前算力需求仍在指数级扩张,而传统电子芯片的制程微缩已逼近物理极限,晶体管密度的提升已然跟不上算力需求的显著增长;与此同时,芯片功耗密度也逼近散热与供电极限,单位算力能耗正成为制约系统规模化部署的核心变量。
与日益放缓的电摩尔定律相对,光摩尔定律才刚刚起步。大模型训练和推理过程所包含的大量矩阵运算,与光传输的物理特征高度契合,光计算由此有了用武之地。
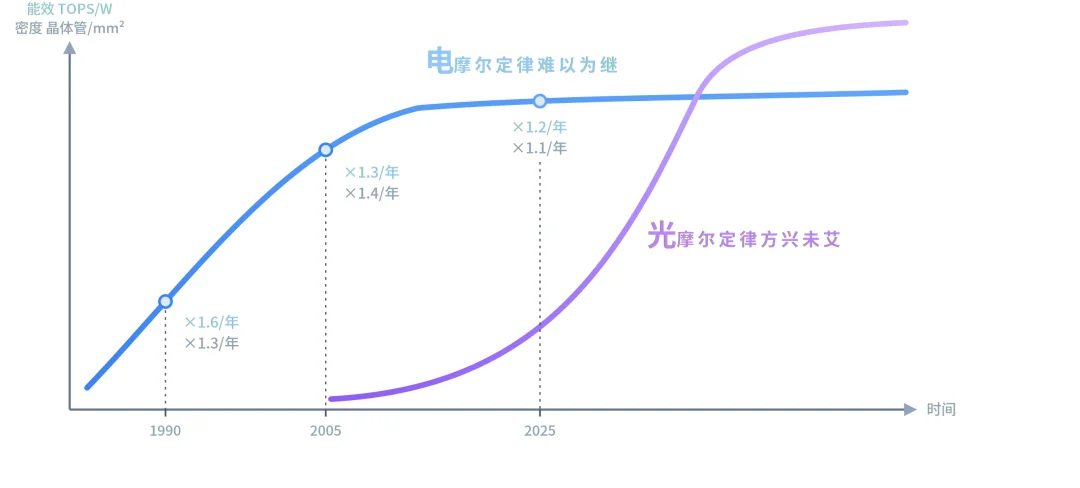
单位功耗算力的年增长率
02超表面光计算核
光子芯力长期专注全波超表面光计算方向的基础研究。超表面以亚波长尺度的介电分布直接编码权重,光穿过结构完成乘法、沿光路传播完成加法,是一种高度紧凑的实现方式,集成密度相比依赖 MZI 搭建权重矩阵的光计算方案高出数个数量级,具备优异的扩展性与能效比。
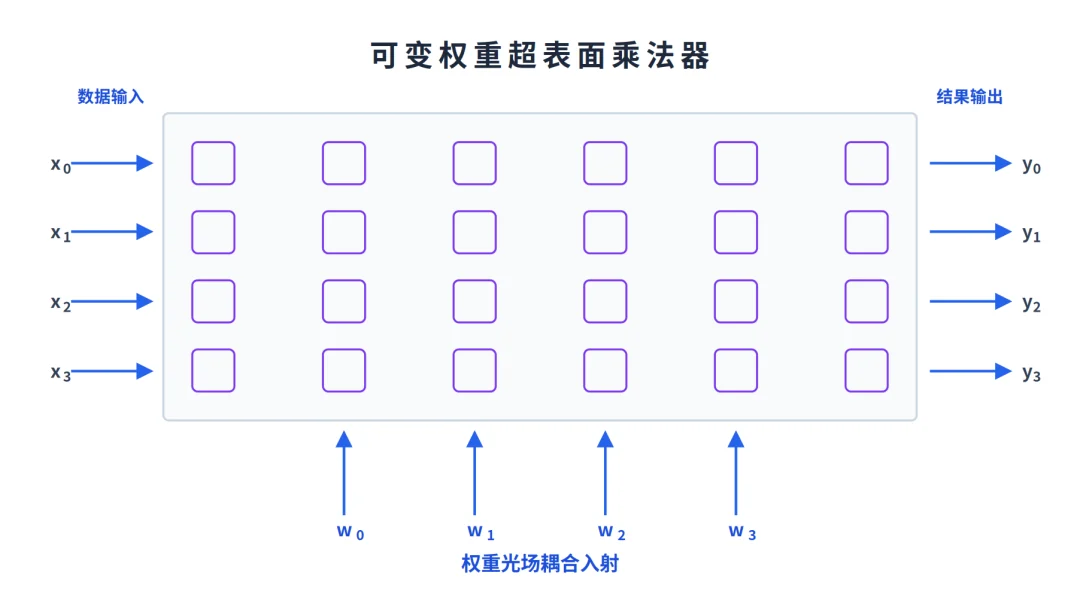
可变权重超表面光计算核
03LightningFlow EPDA™
围绕超表面路线的设计难题,光子芯力自研了 LightningFlow™ 光电协同设计自动化平台:需求与约束先经 LightningAgent™ 转译为设计规格,再交给两项核心工具处理。架构探索工具 LightningDSE™ 采用五档精度的分层建模:从闭式解析公式到逐拍电路仿真直至可综合 RTL,通过跨层排序一致性校准,让几万个候选架构设计点能在可接受时间内完成搜索评估,并可直接为 TPU 类脉动阵列、CNN 权重驻留等常见加速器架构生成 RTL。器件逆设计工具 LightningFNO™ 则用一对傅里叶神经算子替代了传统伴随法驱动的全波仿真迭代,设计速度提升了六个数量级(124 万倍),这项工作获得了今年 DAC 大会的最佳论文提名。
为加速生态建设,光子芯力计划将这套框架的基础能力开源,支持客户私有化部署与二次开发;SaaS 云端服务与高级扩展功能则按商业授权提供。
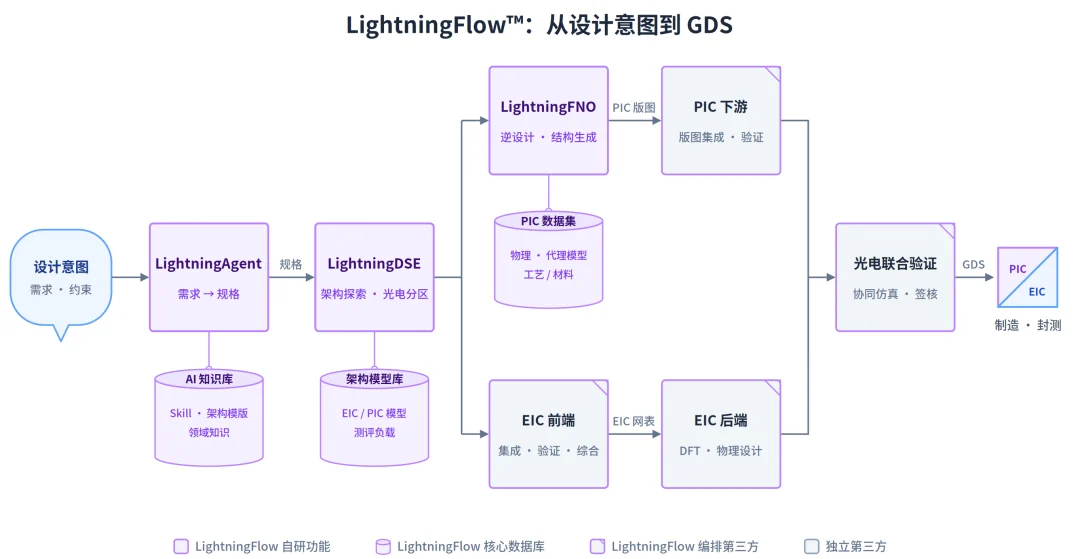
LightningFlow™ 光电协同设计自动化流程
04产品路线:从芯片到集群
基于这条超表面光计算路线,光子芯力规划了从芯片到集群的完整产品路线:PhotonCube™ 是光电异构集成的基础计算芯片,PIC/EIC 芯粒配比可按产品调整。
PhotonEdge™ 是低功耗、高实时性的边缘加速卡,面向产线、工控、机器人等对响应速度敏感的现场场景,承担视觉类小模型推理与训练。
PhotonFabric™ 是光电融合智算服务器卡,实现算力加速与内存/存储池化。PhotonScale™ 是通过光交换横向扩展的智算集群方案,结合 CXL 等互连协议,将光计算单元组织为可组合、可扩展的算力系统,并实现内存与存储资源的池化共享。
四款产品共用同一套芯粒架构与软件栈,从一张卡到整个集群无需为每个规模重新设计。
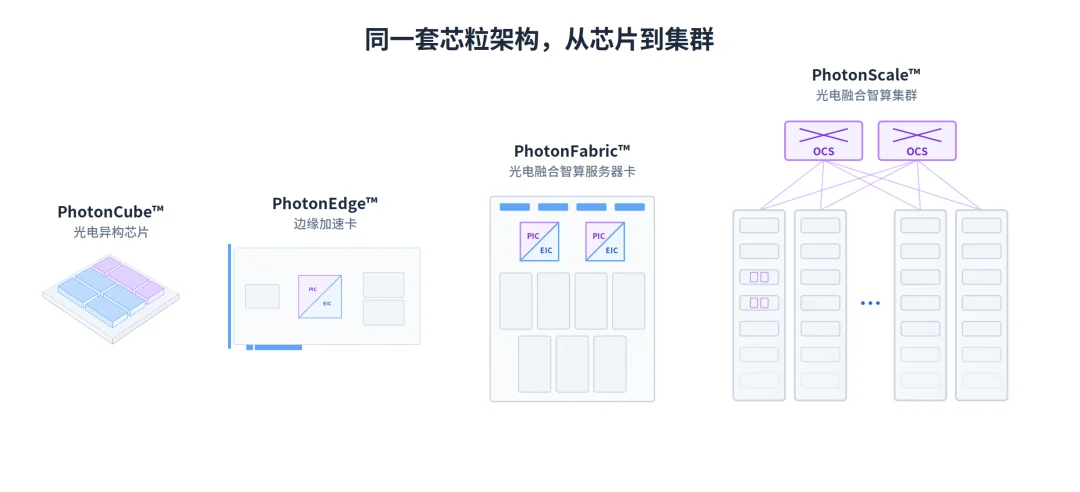
PhotonCube™ / PhotonEdge™ / PhotonFabric™ / PhotonScale™ 产品路线
面向人工智能计算持续增长的算力需求,光电融合计算正从前沿探索走向系统化创新。光子芯力将继续深耕全波超表面光计算技术,协同推进器件、芯片、系统架构与软件平台研发,加快技术验证与产品落地,与产业伙伴共同探索下一代高能效智能计算的新路径,开启光子摩尔的新时代。