当下,人工智能算力需求的呈指数级攀升,已远超摩尔定律下传统电子硬件的性能提升极限,两者间的算力鸿沟正急剧扩大。在此背景下,光子计算具备低延迟、低功耗与高算力的综合特性,这“两低一高”的独特优势,正使其被广泛认为是跨越这一物理瓶颈最具潜力的技术路径。然而,超表面光子芯片的逆向设计高度依赖 FDTD 全波电磁仿真,求解三维网格上的麦克斯韦方程组计算复杂度极高,单次设计迭代动辄数天,严重制约了芯片的设计周期与规模化扩展。
近日,光子芯力(PhotonCore)联合清华大学集成电路学院、湖南大学半导体学院,提出 LightningFNO,一种面向光子矩阵向量乘(Matrix-Vector Multiplication,MVM)计算单元的双傅里叶神经算子模型(Fourier Neural Operator,FNO)的统一框架,首次将 FNO 引入超表面逆向设计领域,实现了从设计目标到可流片拓扑再到系统级光学推理的全流程贯通。相关工作以 "LightningFNO: Ultra-Fast Modeling and Inverse Design for Photonic Matrix–Vector Multiplication Computing Units" 为题发表于国际顶级会议 The 63rd ACM/IEEE Design Automation Conference(DAC 2026),并荣获Best Paper 提名,是获提名的13篇论文中唯一一个光电设计领域的论文。清华大学集成电路学院任天令教授、湖南大学杨其晟副教授为论文通讯作者,光子芯力吴晓萱、林国昌参与本项研究。
01概要
与传统逆向设计方案需逐轮调用全波仿真不同,LightningFNO 通过逆 FNO 快速生成超表面拓扑结构,并由前向CFNO模型即时预测其光学响应,配合置信度引导的自校验机制,实现高质量拓扑的毫秒级生成。针对 4×4 MVM 单元设计,LightningFNO 相比最新的伴随法实现了 1,245,550 倍的加速,同时保持了相当的品质因数(FOM)。在此基础上,团队完成了超表面MVM 芯片流片验证,实测光学响应与理论目标高度吻合,RMSE 仅 0.043;将超表面计算核部署到神经网络后,系统在 MNIST 数据集上取得了97.69%的推理准确率。
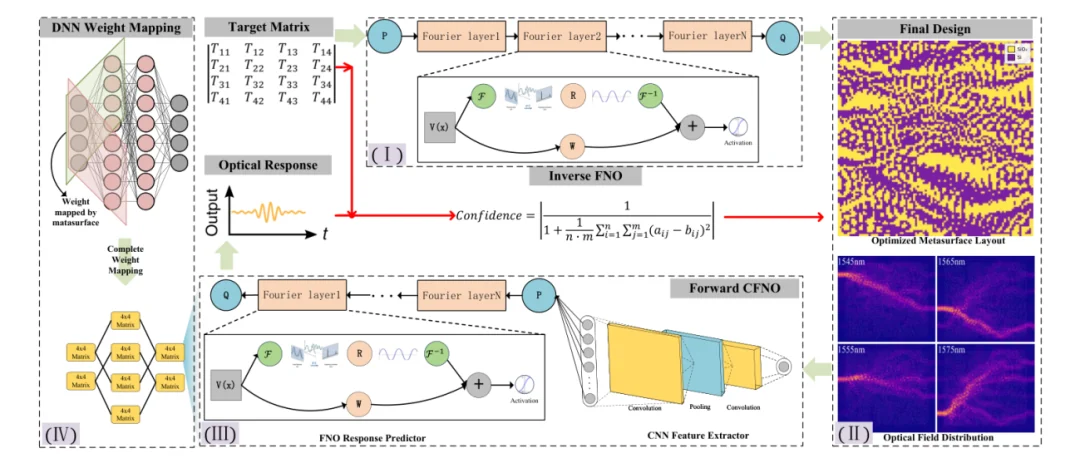
LightningFNO 框架总览:逆FNO生成超表面拓扑 → 前向CFNO预测光学响应 → DNN权重映射(论文Fig.2)
02背景:超表面光子计算的两大挑战
超表面光学神经网络可同时利用衍射、干涉、散射等多种波动光学效应,在超紧凑的芯片上内实现远高于传统方案的计算密度。作为无源器件,其静态功耗可以忽略不计;光穿过超表面的瞬间即可完成矩阵向量乘运算,时间尺度达到飞秒级。但迈向实用化仍横亘两大挑战:
其一,逆向设计成本近乎不可承受。准确的超表面拓扑设计依赖 FDTD 等全波电磁求解器,三维网格求解麦克斯韦方程组资源消耗巨大,设计周期冗长、扩展性差,业界迫切需要可替代 FDTD 的高精度加速仿真框架。
其二,缺乏快速正向仿真器。没有高效的麦克斯韦传播替身(surrogate)模型,大规模光学系统无法端到端仿真。此前绝大多数超表面研究仅停留在小型MVM 单元,极少报道完整的模型级光学推理结果,严重阻碍了光学 AI 硬件走向规模化落地。
03LightningFNO:一次设计,双向打通
LightningFNO 由两个 FNO 模型协同构成:
逆FNO模型作为拓扑生成器,接收目标矩阵 M,直接输出二值化的 101×101 超表面拓扑分布。傅里叶层在频域捕获全局依赖关系,天然适配麦克斯韦场的高维非线性映射,突破了传统方法 20×20 像素小尺度的设计局限。
前向CFNO模型作为响应预测器,在 FNO 前引入CNN 特征提取模块,以拓扑结构、入射光振幅和波长为输入,预测各输出端口的透射响应,充当 FDTD 的神经网络替身,使大规模光网络仿真成为可能。
置信度引导的自校验闭环将目标矩阵与前向预测响应对比,计算置信度评分 C。置信度高的设计直接进入流片;置信度不足的设计自动作为初值交给伴随法精修。这一机制或将实现输出拓扑的"设计即所得",也能极大概率上降低盲目流片的风险。
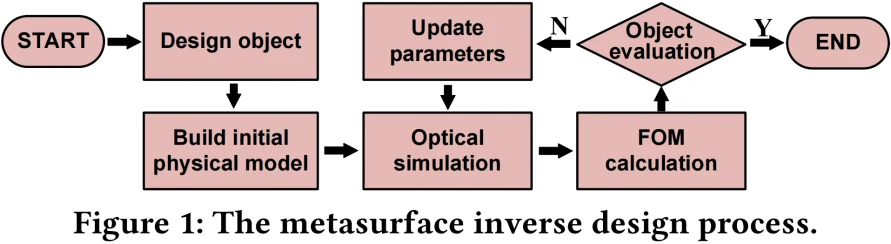
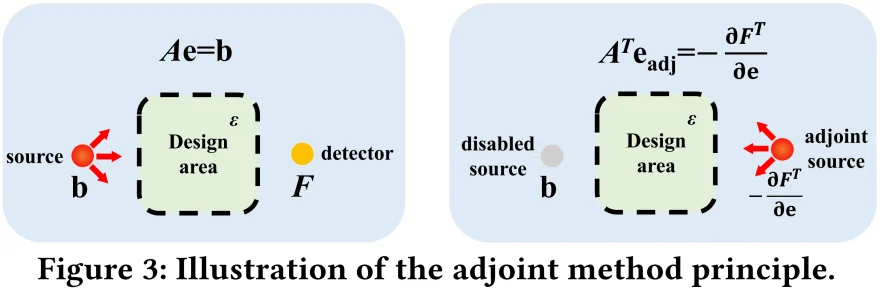
逆设计流程(论文Fig.1)与伴随法原理示意(论文Fig.3)
04数据:千级样本,对称增广至四千
以NVIDIA Volta/Turing 张量核心同规格的 4×4 MVM 为目标,团队设计了 10μm×10μm 的光子乘法单元作为验证结构,随机生成 1,000 个目标矩阵构成初始设计集。通过结构对称性增广——将每个版图沿 x、y 轴镜像,生成功能等价的变体——数据集扩充至 4,000 个样本,扩充训练集并丰富了拓扑样本。也实现了在控制仿真成本的同时显著提升设计空间的覆盖率。
05实验:124万倍加速,性能大范围碾压
在RTX 4090 + Xeon Gold 6330 平台、等光学仿真环境下,团队将 LightningFNO 与遗传算法(Genetic Algorithm,GA)、直接二值搜索(Direct Binary Search,DBS)、伴随法(Adjoint)及 VAE、GAN、CNN 等神经网络加速方法逐一对比:
| 方法 | 迭代次数 | 耗时(s) | FOM |
|---|---|---|---|
| GA | 500 | 32,383.65 | 1.2870 |
| DBS | 500 | 51,592.49 | 0.9267 |
| Adjoint | 110 | 4,982.20 | 0.0175 |
| VAE | — | 0.005 | 1.4678 |
| GAN | — | 0.030 | 1.3213 |
| CNN | — | 0.018 | 1.5694 |
| LightningFNO | — | 0.004 | 0.0175 |
伴随法达到最低FOM 需耗时近 5,000 秒,而 LightningFNO仅需 0.004 秒即取得完全相同的 FOM 0.0175——加速比高达1,245,550 倍。而 VAE、GAN、CNN 等模型虽推理迅速,但在 101×101 高像素、高复杂度设计目标下精度急剧下降,生成结构保真度不足,无法满足流片要求。
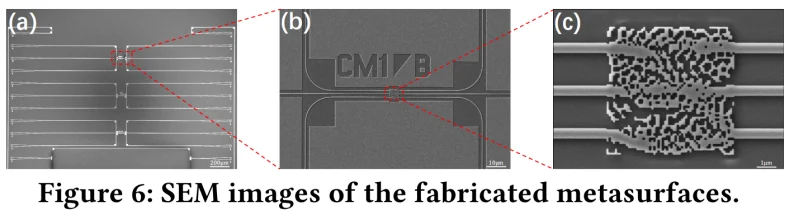
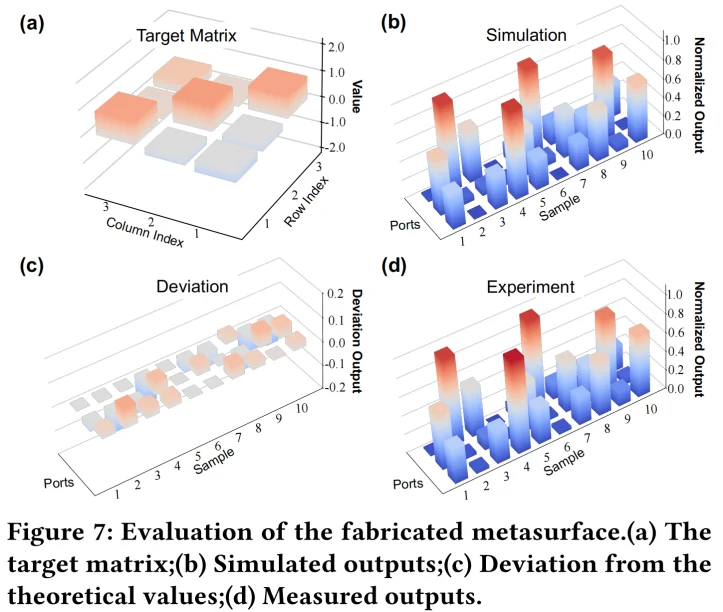
流片超表面SEM 图像(论文Fig.6)与实测结果:目标矩阵、仿真输出、偏差及实测输出(论文Fig.7)
06流片:芯片实测,RMSE 0.043
基于 LightningFNO 预测的结构,团队在 90nm SOI 平台采用电子束光刻(EBL)制备了 3 个 3×3 超表面MVM 单元。首轮流片综合权衡了I/O 数量、测试可行性与器件良率。SEM 多尺度成像证实了制备结构与设计的纳米级一致性;使用 1,000 组随机输入向量实测,输出与目标矩阵的RMSE 仅 0.0430,充分验证了设计—制造闭环的可靠性。
07系统级验证:光学 MNIST 推理 97.69%
为验证前向CFNO 替代 FDTD、支撑大规模部署的可行性,团队将电子CNN 基线(98.29% 准确率)的卷积核映射至超表面MVM 单元,并融入流片实测误差分布建模误差累积。最终,超表面部署网络在 10,000 张测试图片上取得了 97.69% 的准确率,仅较电子基线下降0.60个百分点—证实了 LightningFNO 设计的超表面可以作为大规模光学神经网络的基础计算单元,支撑光子芯片的规模化集成,为后续大规模光学AI系统提供建模与设计基础”。
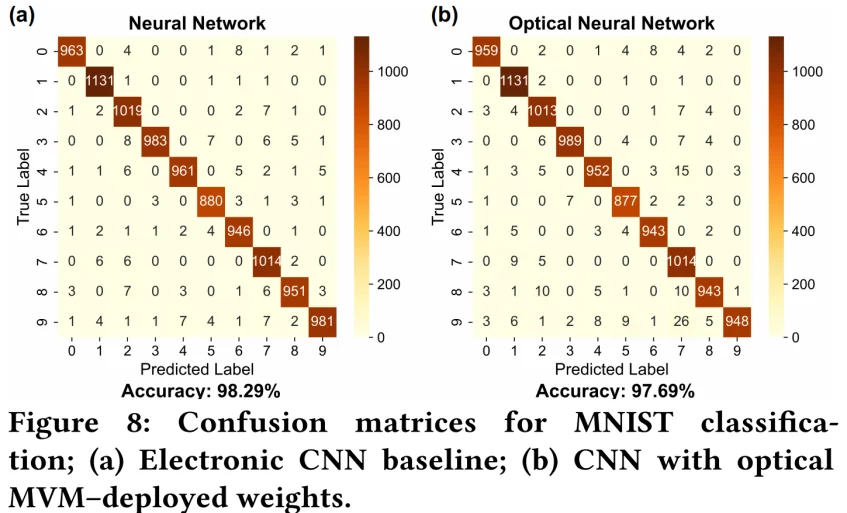
MNIST 分类混淆矩阵对比:电子CNN基线vs超表面部署(论文Fig.8)
论文信息
Li, M., Yang, Q., Zhang, Y., Wu, X., Lin, G., Ren, T. LightningFNO: Ultra-Fast Modeling and Inverse Design for Photonic Matrix–Vector Multiplication Computing Units.
The 63rd ACM/IEEE Design Automation Conference (DAC 2026).
作者单位:湖南大学物理与微电子科学学院、湖南大学半导体学院(集成电路学院)、清华大学集成电路学院、光子芯力(北京)科技有限公司